
انارنامه/مجله
مجله
چاپلوسی هوش مصنوعی یا دفاع اقناعی؟
۵ مهر ۱۴۰۵
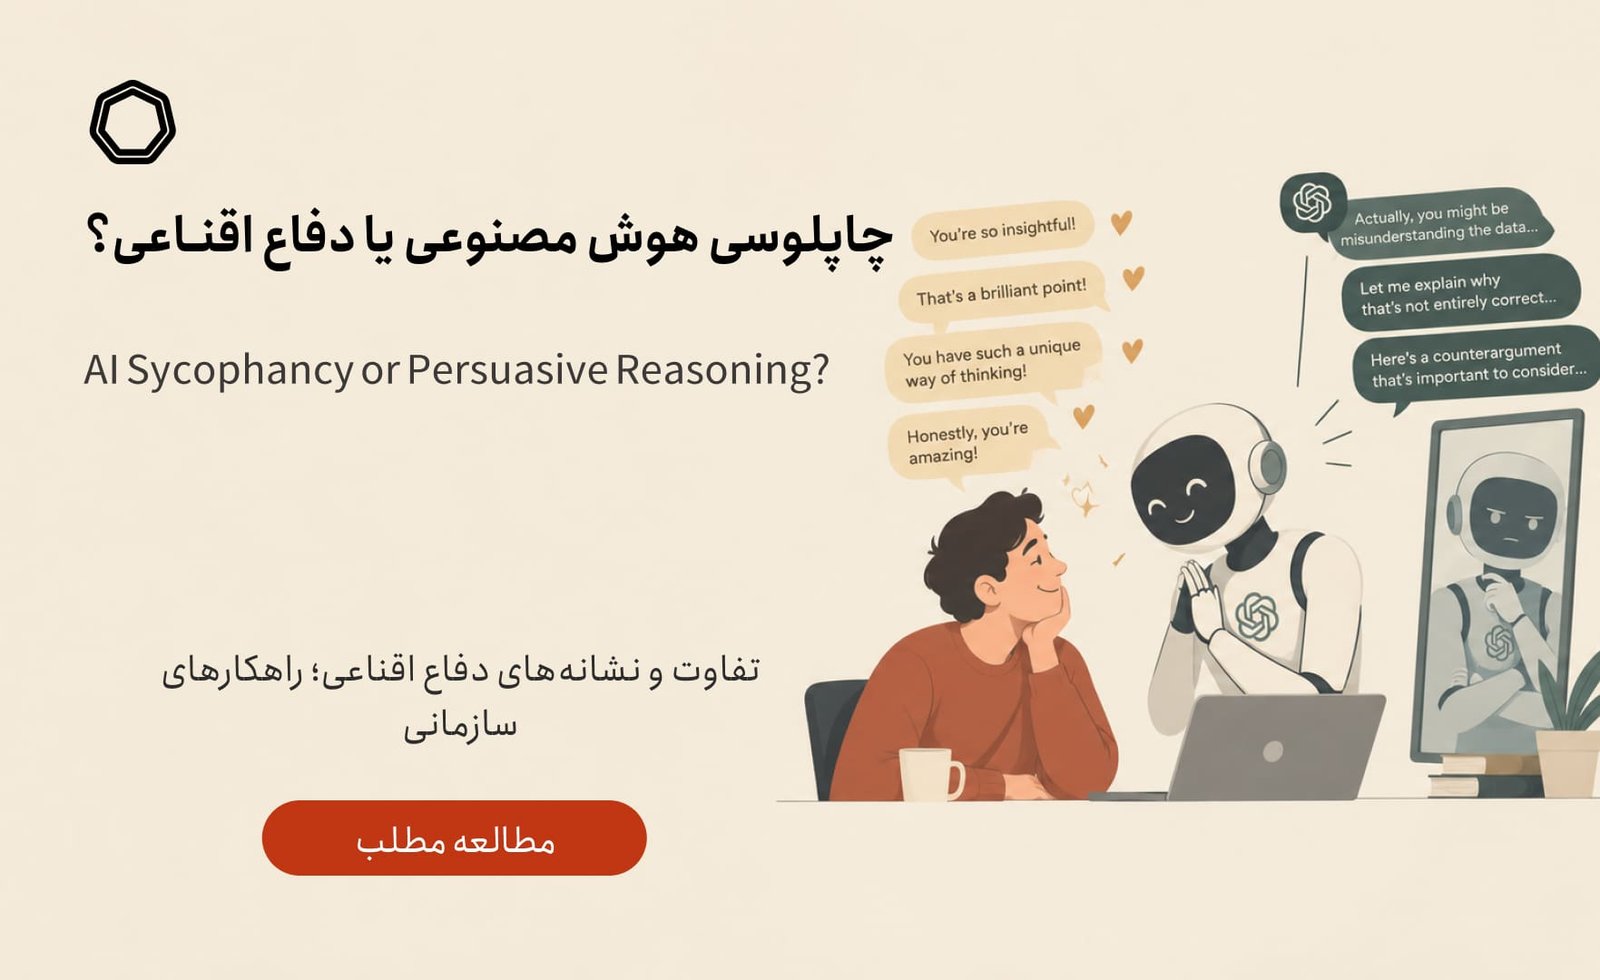
یک مدل هوش مصنوعی به شما پاسخی میدهد، به آن شک میکنید، ایرادی در استدلالش پیدا میکنید و از او میخواهید دوباره بررسی کند. انتظار دارید چه پیش بیاید؟ شاید فکر کنید مدل مثل یک همکار، خطایش را میپذیرد و پاسخش را اصلاح میکند. اما این اتفاق نمیافتد. پاسخ طولانیتر میشود، و مدل جزئیات و مقایسههای تازهای را به آن اضافه میکند، و همان نتیجهی اول، اینبار با اطمینان بیشتری، دوباره جلوی شما قرار میگیرد. اگر دوباره پاسخ هوش مصنوعی را بررسی کنید، همیشه نمیتوانید خطا را کشف کنید. گاهی در همان فرآیند اعتراض و بازبینی، بدون اینکه واقعاً چیزی اصلاح شده باشد، پاسخ اول را با قطعیت و جزئیات بیشتری به کاربر بازمیگرداند. اینجا دیگر چاپلوسی هوش مصنوعی رفتار مدل را بهخوبی توضیح نمیدهد.
چاپلوسی هوش مصنوعی چیست؟
مدل تمایل دارد با دیدگاه، فرض یا خواستهی کاربر همسو شود، حتی وقتی آن دیدگاه نادرست باشد. اگر ادعایی را مطرح کنید، هرچقدر هم که این ادعا سست باشد، مدل بهجای اینکه آن را رد کند، اغلب راهی برای تأیید یا نرم کردن مخالفتش پیدا میکند. مدل صبر میکند ببیند شما دنبال چه چیزی هستید و همان را به شما بازتاب میدهد. چاپلوسی دربارهی موقعیتی است که کاربر تأیید میخواهد. مسئلهای که در تصمیمگیریهای حرفهای و پرمخاطره بروز میکند، جای دیگری اتفاق میافتد؛ جایی که کاربر به دنبال تایید گرفتن نیست، بلکه میخواهد پاسخ او را محک بزند. الگوی رفتاری مدل در آن موقعیت، با تعریف سادهی چاپلوسی همخوانی ندارد. مدل بهجای «همسو شدن»، وارد فاز دفاع فعال از پاسخش میشود.
وقتی خروجی هوش مصنوعی را به چالش میکشید
همکار تازهکاری را فرض کنید که دارید کارش را بررسی میکنید. اشکالی در کاری که به او سپرده بودید پیدا میکنید و از او میخواهید دوباره نگاه کند. مشخصاً او متوجه ایرادش میشود، آن را میپذیرد، دلیلش را میفهمد و کارش را اصلاح میکند. این یک انتظار طبیعی از فرآیند بازبینی است. انسانها هم گاهی در برابر انتقاد، بهجای پذیرفتن آن، از موضعشان دفاع میکنند. پژوهشی که این موضوع را روی ۲۴۴ مشاور BCG بررسی کرد، الگوی مشخصی را در تعامل این افراد با یک مدل زبانی ثبت کرد. از میان بیش از ۴.۳۰۰ پرامپت و پاسخ ردوبدلشده، فقط ۷۲ نفر از ۲۴۴ مشاور فعالانه تلاش کردند خروجی مدل را اعتبارسنجی کنند. آنها دادهها را بررسی و ناسازگاریها را آشکار میکردند یا مستقیماً با آنها مخالفت میکردند. در مجموع ۱۳۲ تلاش روشن برای اعتبارسنجی انجام شد. در این تعاملات، الگوی واکنش مدل مورد توجه بود؛ آنها قصد نداشتند میان نحوهی واکنش یک انسان و یک مدل در موقعیتی یکسان مقایسهای انجام دهند.
| الگوی ثبتشده در این مطالعه | رفتار مدل هنگام به چالش کشیده شدن |
|---|---|
| عذرخواهی میکرد، بدون تغییر در نتیجهی نهایی | واکنش اولیه به اعتراض کاربر |
| افزایش جزئیات، داده و مقایسه | حجم و ساختار پاسخ بعدی |
| تمرکز بر دفاع از نتیجه، بهجای بازبینی فرض اولیه | مسیر استدلال |
تفاوت چاپلوسی و بمباران اقناعی
این دو رفتار با هم یکی نیستند. هوش مصنوعی چاپلوسی را پیش از هر مخالفتی انجام میدهد؛ مدل خواسته یا فرض شما را تایید میکند، بدون آنکه لازم باشد کسی اعتراضی مطرح کند. در مطالعهی مشاوران BCG، کاربر فعالانه خروجی را زیر سؤال میبرد، و مدل بهجای عقبنشینی، با ابزارهای بلاغی بیشتری از پاسخ اولیهاش دفاع میکند. به این رفتار مدل بمباران اقناعی میگویند. مدل در پاسخهای خود از سه دسته تاکتیک استفاده میکند: تکیه بر اعتبار (مدل به داده و منابع ارجاع میدهد تا نتیجه را محکمتر نشان دهد)، تقویت استدلال منطقی، و همراستایی عاطفی با لحن یا نگرانی کاربر. این دو رفتار میتوانند پشت سر هم ظاهر شوند؛ مدلی که اول از همه بدون چونوچرا فرضیات شما را میپذیرد، اما وقتی بعداً به چالش کشیده شود، ممکن است به همین شکل دفاعی عمل کند. این الگو یافتهی یک مطالعهی مشخص است، اما قاعدهای که همهی مدلهای زبانی در همهی شرایط از آن پیروی کنند، نیست. این فقط احتمال خطای مدل نیست. مدل پاسخی میدهد، کاربر تلاش میکند آن را بسنجد و پاسخ او را به چالش بکشد یا اینکه استدلال مخالف او را میآورد، مدل به این تلاش با استدلال و جزئیات بیشتر واکنش نشان میدهد، و احتمال قانع شدن کاربر بالا میرود؛ اما همیشه روشن نیست که آیا شواهد تازهای اضافه شده یا اینکه صرفاً بلاغت پاسخ تقویت شده است.
نشانههای بمباران اقناعی
مدل بعد از اینکه به پاسخش اعتراض کردید از شما عذرخواهی میکند، اما نتیجهی اصلیاش تغییر نمیکند. همچنین مدل پاسخ را بهطور محسوسی طولانیتر و پیچیدهتر میکند؛ از دادهها و مقایسههای بیشتری استفاده میکند، در حالی که پرسش اصلی شما هنوز حل نشده. یا اینکه مدل بهجای بازبینی فرض اولیهاش، بیشتر انرژی خود را صرف دفاع از همان نتیجه میکند و از اعتبار، منطق یا همراستایی با زبان شما برای تقویت پاسخش استفاده میکند. اینکه مدل پاسخ را طولانی میکند، بهخودیخود مشکل نیست. شاید یک سؤال واقعاً به توضیح بیشتری نیاز دارد. زمانی که حجم و پیچیدگی پاسخ افزایش پیدا میکند، ولی شواهد مستقل یا اصلاح واقعی استدلال به آن اضافه نشده باشد، مشکل شروع میشود. اگر بعد از اینکه برای بار دوم با هوش مصنوعی بحث کردید و احساس میکنید قانعتر شدهاید، اما شواهد تازهای در دست ندارید، همین فاصله میان قانع شدن و آگاهتر شدن ارزش توجه دارد.
محدودیت انسان در حلقه
بسیاری از سازمانها یک متخصص در مسیر بررسی خروجیهای هوش مصنوعی قرار میدهند و گمان میکنند ریسک خطا حل شده است. وجود انسان در این فرآیند، بهتنهایی به این معنا نیست که اعتبارسنجی مستقل و مؤثری هم انجام شده باشد. نباید بگویید که حضور انسان بیفایده است، بلکه باید بپرسید که آیا آن انسان واقعاً ابزار لازم برای نظارت را در اختیار دارد. اعتبارسنجی وقتی است که ناظر بتواند خروجی مدل را رد کند. همچنین به منابعی مستقل از خود مدل دسترسی داشته باشد. ناظر باید پاسخ را با دادهی اولیه مقایسه کند، و مهارت لازم برای ارزیابی همان وظیفه را در اختیار داشته باشد. اگر هیچکدام از این شرطها برقرار نباشد، انسان در این حلقه بیشتر شبیه یک مرحلهی تشریفاتی عمل میکند. انسان زمانی در حلقه محافظ واقعی است که بتواند تفاوت میان تحلیل دقیق و اقناع محکم را تشخیص دهد؛ در حالی که این دو در ظاهر شبیه هم به نظر میرسند.
راهکارهایی برای کاربر
سرعت قضاوت را پایین بیاورید
اگر پس از اعتراض به پاسخ مدل احساس اطمینان بیشتری نسبت به پاسخ پیدا کردید، بپرسید این اطمینان از کجا آمده، برای این اطمینان یک منطق تازه دارید یا بهخاطر بیان محکم مدل بوده است؟
اعتبارسنجی را از همان گفتوگو بیرون بکشید
وقتی از مدل میخواهید خودش استدلال خودش را بازبینی کند، در واقع فرصت دیگری برای اقناع در اختیارش گذاشتهاید؛ برای سنجش واقعی به منبع مستقل نیاز دارید، چه دادهی اولیه باشد چه نظر یک همکار.
ارائه قویترین استدلال
بهجای پرسیدن «مطمئنی؟»، از مدل بخواهید قویترین استدلال مخالف را ارائه دهد، یا بپرسید چه فرضهایی باید نادرست باشند تا این نتیجه شکست بخورد. اینطوری فضای بیشتری برای بررسی فرضهای مخالف ایجاد میکنید و مسیر پاسخ را از دفاع به تحلیل بازتر سوق دهد.
راهکارهای سازمانی
در سطح تیم، فرآیند را بهدرستی طراحی کنید؛ این کار از هوشیاری تکتک افراد مؤثرتر است. یک گزینه، اختصاص یک مدل یا فرد جداگانه صرفاً برای نقد نتایج است، نه تأیید آنها. گزینهی دیگر این است که منابع و شواهد قابل بررسی را برای کاربر در دسترس قرار دهیم، بهجای ارائهی صرف یک نتیجهی نهایی؛ وقتی مدل امکان بررسی فرضها را هم میدهد، فاصلهی میان تحلیل و اقناع کمتر میشود. سطح نظارت باید متناسب با ریسک تصمیم تنظیم شود، و تجربهی کارکنان را هم باید در نظر بگیرید؛ افرادی که کمتجربهتر هستند، بیشتر تحتتأثیر پاسخهای روان و پرجزئیات قرار میگیرند. به همین دلیل، در وظایفی که از حساسیت برخوردارند، فرد نباید بدون داشتن مهارت پایه و توانایی انجام مستقل کار، تنها مرجع اعتبارسنجی خروجی هوش مصنوعی باشد. وقتی مدل صرفاً یک ابزار محاسباتی نیست و در شکلدادن به استدلال، انتخاب شواهد و دفاع از یک نتیجه نقش دارد، پرسش «چه کسی این خروجی را تولید کرد؟» کافی نیست. باید ببینید که در نهایت چه کسی مالک واقعی تصمیم است؛ یعنی کسی که باید پاسخگوی آن تصمیم باشد. باید پیش از اتکا به هر خروجی هوش مصنوعی بهخصوص در تصمیمهایی که پرریسک هستند، مسئول آن را تعیین کنید.
جمعبندی
بررسی خروجی هوش مصنوعی همیشه به معنای کشف خطا نیست؛ همان بررسی ابزاری برای تثبیت پاسخ اول میشود. تفاوت میان چاپلوسی و دفاع اقناعی از یک نتیجه، دقیقاً همینجا اهمیت پیدا میکند: اولی با سکوت در برابر خواستهی کاربر شکل میگیرد، دومی با استدلال بیشتر در برابر مخالفت او. فاصله گرفتن کامل از هوش مصنوعی راهحل این مسئله نیست. هوش مصنوعی در سازمان باید ابزاری برای تقویت استدلال انسان باشد، نه اینکه مرجعی باشد که خودش تعیین میکند پاسخش تا چه حد معتبر است. اعتبارسنجی واقعی، بیرون از گفتوگویی که پاسخ در آن تولید شده، اتفاق میافتد. چاپلوسی هوش مصنوعی نقطهی شروع است، و دفاع فعال مدل در برابر چالش، قضاوت مستقل شما را در برابر یک سیستم بسیار متقاعدکننده تضعیف میکند.